Cruzar datos por identificador: no emparejar filas por casualidad
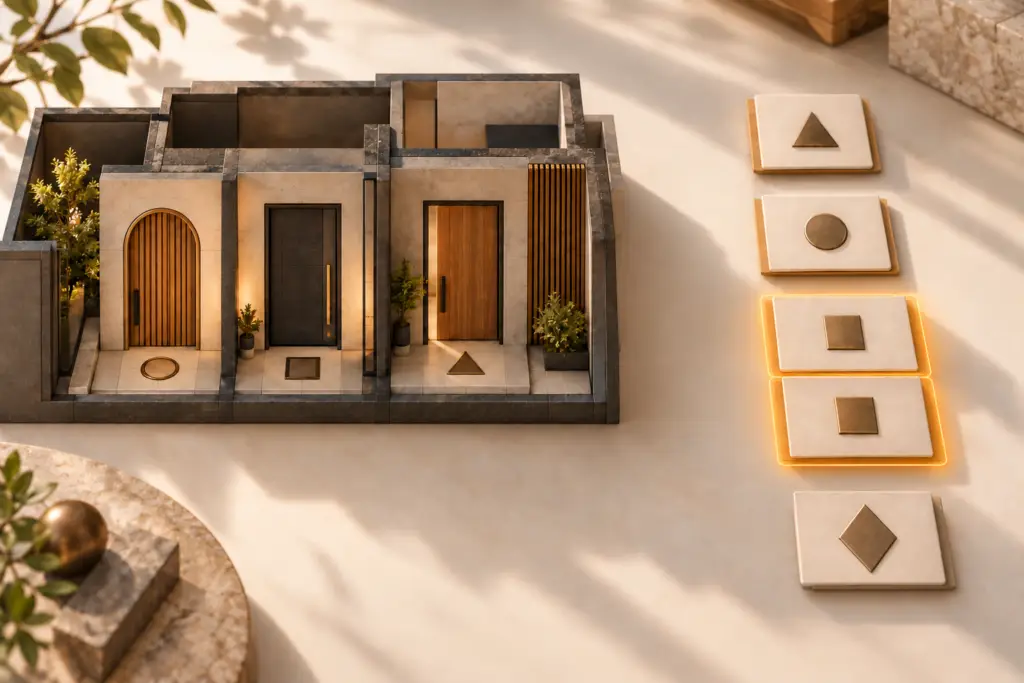
Ordenar dos listas y juntar la primera fila con la primera fila tiene una virtud: se programa muy deprisa. También puede asignar el código de una puerta a otra sin producir un solo error de ejecución. El programa termina, la tabla sale limpia y el desastre conserva una alineación impecable. Si además ambas listas tienen la misma longitud, habrá quien lo dé por validado. Yo reservaría los aplausos hasta comprobar a quién pertenece cada dato.
Cruzar datos por identificador consiste en relacionar registros mediante una clave compartida, en lugar de confiar en su posición. Vamos a hacerlo con un inventario de puertas y una tabla de códigos, primero en Python y después en C#. El resultado separará propuestas, conflictos y registros sin pareja. No escribiremos en un modelo: aprenderemos a decidir qué asociaciones están justificadas antes de concederle al programa ese privilegio.
La posición cambia; la identidad necesita un acuerdo
Un inventario contiene P01, P02 y P03. La tabla del proveedor empieza por P02 y después incluye P01. Si emparejas por posición, el primer código termina en P01 aunque pertenezca a P02. No hace falta que falte una fila ni que el archivo esté corrupto: basta con que alguien haya ordenado la tabla por otro criterio. Dos documentos perfectamente legibles pueden describir las mismas cosas en órdenes distintos.
Ordenar ambos por identificador mejora esa situación solo mientras se cumplen otras condiciones. Si una tabla contiene un elemento adicional, falta una puerta o aparece una clave repetida, las posiciones dejan de tener la correspondencia que estabas dando por supuesta. La igualdad de tamaños tampoco demuestra nada: puedes tener una ausencia y un registro sobrante que se compensen numéricamente. Tres filas contra tres filas sigue sin ser una prueba de identidad; la aritmética tiene bastantes problemas propios como para encargarle también la coordinación del proyecto.
La pregunta útil es otra: para una clave concreta, ¿cuántos elementos existen en el inventario y cuántas filas de datos hemos recibido? Una pareja de uno y uno permite preparar una propuesta. Dos filas para el mismo elemento necesitan revisión, aunque los códigos coincidan. Un elemento sin fila carece de dato en esta entrega; una fila sin elemento puede corresponder a otra versión, a otro alcance o a un identificador mal escrito. El cruce debe conservar esas diferencias porque cada una conduce a una decisión distinta.
Esto es una relación uno a uno definida para nuestro ejercicio. Otros procesos admiten varias filas por elemento: mediciones desglosadas, capas o revisiones históricas, por ejemplo. En esos casos debes definir qué significa esa multiplicidad y cómo se consume. Copiar una regla uno a uno a cualquier conjunto de datos sería cambiar una casualidad por otra, esta vez con mejores nombres de variables.
Elegir la clave incluye decidir dónde es única
P01 será aquí un identificador didáctico, no un identificador real de Revit o IFC. El campo codigo representa el dato que queremos asociarle y puede ser distinto de la clave. Conviene separar ambos papeles: si usas como identidad el mismo valor que estás intentando corregir, una corrección puede destruir la referencia que necesitabas para localizar el elemento. Es una forma muy eficiente de perder al paciente en mitad de la operación.
Antes de cruzar archivos reales, acuerda de dónde sale la clave, dentro de qué ámbito es única y si se conserva entre las versiones que estás comparando. Una marca de puerta puede repetirse en varios edificios; en ese contexto quizá necesites una clave compuesta por edificio e identificador. Un identificador procedente de una aplicación también tiene un ámbito y unas condiciones de persistencia que debes comprobar en su documentación. La apariencia de número largo no concede inmunidad contra los problemas de identidad.
En el ejemplo compararemos texto exactamente: P01 y p01 serán claves diferentes. Tampoco quitaremos espacios a escondidas. Un identificador vacío o formado solo por espacios se rechazará; uno con espacios alrededor seguirá siendo diferente del que no los tiene. Es una política deliberadamente sencilla que evita inventar equivalencias. Si tu fuente necesita normalización, define esa regla antes y conserva el valor original para poder investigar las colisiones que introduzca.
Para preparar el cruce sirven los diccionarios y mapas, pero hay una trampa: guardar directamente una fila por clave puede sobrescribir la anterior. Si haces eso antes de contar repeticiones, el duplicado desaparece de la estructura y el informe resulta tranquilizador por falta de pruebas. Agruparemos todas las filas de cada clave; después decidiremos qué hacer con cada grupo. La comparación de conjuntos ayuda a reunir las claves de ambos lados, aunque por sí sola no conserva cuántas veces aparecía cada una.
Python: conservar los grupos antes de proponer una asociación
Guarda este programa como cruzar.py. Necesita Python 3 y no utiliza paquetes externos. Los datos están dentro del archivo para que puedas cambiar una fila y ver qué ocurre sin añadir todavía la lectura de CSV. Hay tres elementos en el inventario y cuatro filas en la tabla: P02 aparece dos veces, P03 no tiene dato y P99 no está en el inventario.
Ejecuta el archivo desde su carpeta:
Verás cuatro líneas. P01 queda como propuesta | D01; P02 muestra conflicto | elementos=1, filas=2; P03 aparece sin dato y P99, sin elemento. La segunda fila de P02 no ha ganado por llegar después. Tampoco hemos elegido D02 porque parezca más convincente que D99. El programa sabe contar coincidencias; para resolver cuál es la correcta necesita una regla o una revisión que aquí no hemos proporcionado.
setdefault crea una lista cuando encuentra una clave nueva y devuelve la existente en las siguientes apariciones. Así mantenemos todas las filas. La unión de las claves permite visitar también las que solo están en uno de los orígenes; get proporciona una lista vacía cuando falta el otro lado. El orden final se fija con sorted para que el informe sea fácil de comparar entre ejecuciones. Ese orden organiza la presentación: no decide las parejas.
Fíjate también en la prioridad del conflicto. Si P99 apareciese dos veces en la tabla, informaríamos de la repetición aunque no hubiera elemento. No ocultamos una anomalía detrás de otra. En un informe de producción podrías separar ambas incidencias en columnas y conservar los números de fila de origen. Aquí preferimos una salida pequeña que deja visible el criterio y que puedes comprobar a mano.
C#: la misma regla con una comparación explícita
Vamos a repetir el caso en una aplicación de consola de .NET 8. Desde una carpeta de trabajo, crea el proyecto:
Sustituye CruceIdentificadores/Program.cs por el programa completo siguiente. GroupBy conserva los grupos y StringComparer.Ordinal establece una comparación de cadenas sensible a mayúsculas y sin reglas lingüísticas. Usamos el mismo comparador al agrupar, construir los diccionarios, reunir las claves y ordenar el informe: la identidad no debería cambiar de criterio en mitad del recorrido.
Ejecuta el proyecto desde la carpeta en la que lo creaste:
La salida del caso propuesto coincide con la de Python. En C# contamos los elementos de cada grupo en lugar de conservar una lista de identificadores repetidos, porque para esta decisión necesitamos su cantidad. En las filas sí mantenemos el grupo para recuperar el código cuando existe una única coincidencia. Son dos representaciones del mismo contrato, no dos oportunidades para que cada lenguaje improvise su propia política de duplicados.
grupo! no verifica nada por sí mismo: indica al análisis de nulabilidad del compilador que en ese punto esperamos un valor no nulo. La garantía procede de las ramas anteriores y del tamaño del grupo: solo llegamos a consultar su primera fila cuando hay un elemento y una fila. Añadir un signo de admiración a una variable no es una estrategia de validación, por mucho carácter que le dé al código.
La prueba decisiva es cambiar los datos sin cambiar la regla
Invierte el orden de las filas y del inventario. El informe debe seguir mostrando las mismas cuatro asociaciones porque las decisiones dependen de las claves y de las cantidades, no de la posición. Después cambia D99 por D02: P02 debe seguir siendo un conflicto. Dos filas iguales siguen siendo dos filas; aceptar una de ellas automáticamente requeriría una política de deduplicación explícita y trazable, no una amnesia selectiva del diccionario.
Añade otra P01 al inventario y observa cómo deja de ser una propuesta: ahora hay dos elementos candidatos para un único dato. El caso importa porque a menudo se valida la tabla recibida y se da por supuesto que el origen propio es impecable. Es una cortesía innecesaria con nuestros errores. La unicidad debe comprobarse en ambos lados del cruce, dentro del alcance que hemos elegido.
Prueba también una clave vacía, un inventario vacío y una tabla vacía. La primera debe detener la operación con un error; los otros dos casos pueden producir, respectivamente, filas sin elemento o elementos sin dato. Si ambos orígenes están vacíos, el resultado será vacío. P01 y p01 seguirán separados. Estas comprobaciones permiten explicar por qué aparece cada resultado y hacen bastante más por la confianza que un mensaje verde que diga «proceso completado».
Una propuesta tampoco demuestra que D01 pertenezca al catálogo válido, que el elemento admita escritura o que nadie lo haya cambiado desde la lectura. Este ejercicio garantiza únicamente una correspondencia uno a uno bajo la política descrita y comprueba que el código sea texto no vacío. Al conectar el cruce con una herramienta que modifique un modelo habrá que validar el dato y volver a comprobar el destino antes de escribir. La palabra propuesta está ahí por una razón; no la promociones a orden de ejecución por entusiasmo.
La documentación de estructuras de datos de Python explica los diccionarios y conjuntos que hemos combinado, y la referencia de GroupBy de .NET desarrolla la agrupación por clave y sus comparadores. Puedes reutilizar esta lógica al leer un CSV, recibir JSON o preparar una revisión de parámetros: lo que cambia es la entrada, mientras que la obligación de justificar cada pareja permanece.
¿En tus intercambios qué se repite antes: los identificadores, las filas o la confianza en que todo viene ordenado? Cuenta en los comentarios qué clave utilizáis y en qué situación dejó de ser suficiente. Y si alguien de tu equipo sigue uniendo tablas por número de fila, compártele este ejemplo antes de que el próximo informe salga perfecto y esté completamente equivocado.
Respuestas