Visor IFC web: qué mirar antes de elegir tecnología
El cubo de ejemplo abre rápido y la cámara responde. Podríamos declarar ganador al visor y reservar para producción el descubrimiento de las instalaciones, las coordenadas y los datos que nadie encuentra. Es una tradición tecnológica muy entretenida para quienes no tienen que dar soporte después. Yo propondría una prueba menos complaciente: utilizar modelos representativos y preguntar qué trabajo permite hacer el visor, no cuánto entusiasmo produce su primera vuelta de cámara.
Para elegir un visor IFC web conviene empezar por las tareas que debe permitir terminar y por los archivos con los que tendrá que hacerlo. Aquí propongo un método de evaluación para un equipo hipotético que necesita revisar arquitectura e instalaciones y compartir algunas consultas con el cliente. No es una clasificación de productos ni una prueba comparativa ejecutada: es una forma de reunir evidencias antes de adoptar una tecnología, contratar una plataforma o empezar a construir una propia.
Definir qué significa trabajar bien con tus modelos
El equipo necesita acordar quién utilizará el visor y con qué propósito. Una persona externa puede querer localizar una sala y consultar su superficie; coordinación necesita aislar sistemas y entender una interferencia; desarrollo puede necesitar integrar la selección de elementos en un portal. Las tres utilizan un modelo, pero no piden el mismo producto. Si mezclamos sus requisitos en una lista sin prioridades, acabaremos premiando la herramienta que anuncie más funciones, aunque las tres tareas principales sigan siendo incómodas.
Para preparar la evaluación elegiría un archivo representativo de consulta ligera, otro exigente por geometría o cantidad de objetos y una combinación de disciplinas con referencias conocidas. No se trata de fabricar una tortura artificial ni de enviar toda la documentación del estudio a cualquier servicio de prueba. Los archivos deben poder compartirse en ese entorno y reflejar el trabajo previsto. Conviene conservar la misma versión de cada uno para todos los candidatos: comparar distintas exportaciones introduciría una variable precisamente donde necesitamos saber qué está interpretando cada visor.
Antes de abrirlos, anotaría unos resultados esperados. Por ejemplo, localizar una sala determinada, consultar una propiedad concreta de una puerta y aislar el sistema de ventilación de una planta. Podemos añadir una posición conocida de encuentro entre disciplinas y un elemento con un dato ausente. Esa pequeña colección nos permite distinguir entre una tarea completada, una función que existe pero no hemos sabido usar y un caso que el producto no resuelve. Las tres situaciones merecen decisiones distintas; la casilla «sí» suele tratarlas con una hospitalidad excesiva.
También definiría qué condiciones descartan una solución. Si el proyecto exige que los datos permanezcan en un entorno autorizado, ese requisito no debería compensarse con cinco puntos por sombreado. Si coordinación necesita abrir varias disciplinas juntas, un producto que solo resuelve consultas aisladas puede servir para otro uso, pero no supera este. Los criterios eliminatorios protegen la necesidad principal antes de valorar comodidades. Evitan que una media aritmética termine escogiendo una herramienta incapaz de hacer justo aquello para lo que se buscaba.
Revisar la geometría y los datos que sostienen la decisión
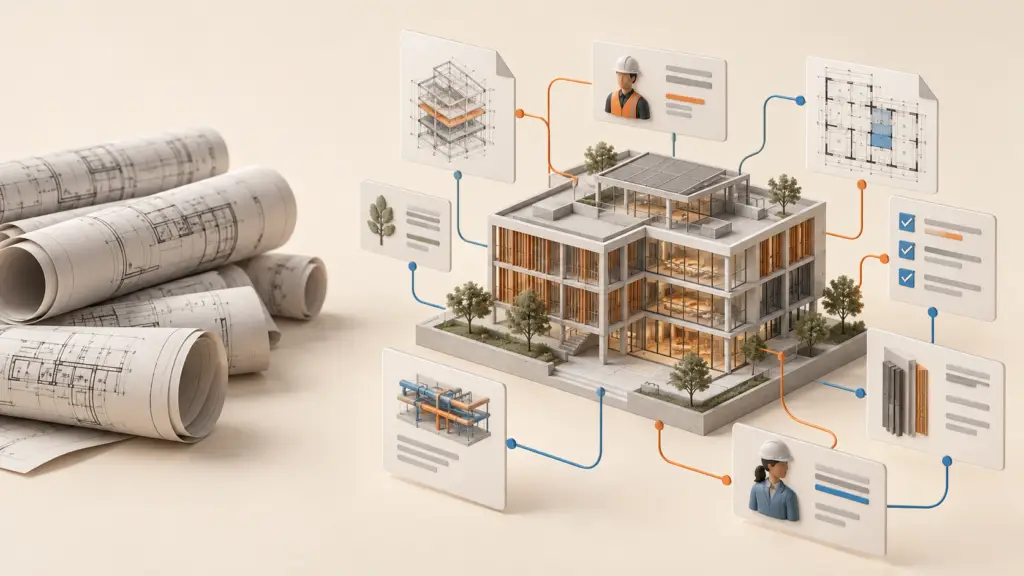
IFC organiza información de objetos y relaciones, además de su representación geométrica. La biblioteca de especificaciones de buildingSMART distingue sus versiones y documentación. Por eso «abre IFC» necesita concretarse: qué esquema usa nuestro archivo, qué contenido necesitamos interpretar y qué admite la implementación evaluada. El logotipo del estándar resulta tranquilizador, pero no hace la revisión de nuestros huecos ni sabe qué clasificación ha pedido el proyecto.
Comenzaría por zonas donde un error tenga consecuencias para la tarea: pasos de instalaciones, huecos, elementos inclinados o encuentros entre disciplinas. Conviene contrastar los casos dudosos con información de referencia y, cuando sea necesario, con la herramienta de origen. Si un elemento no aparece, hay que investigar si falta en la exportación, si el importador lo omite o si un filtro lo mantiene oculto. Declarar defectuoso al visor sin distinguir esas causas puede hacernos cambiar de producto para conservar exactamente el mismo problema.
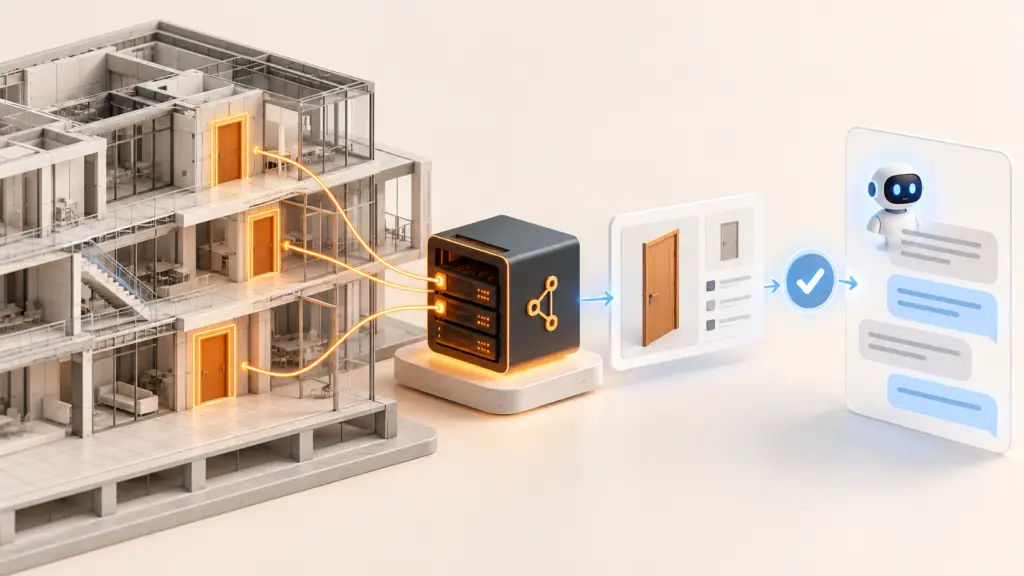
La selección también merece una prueba propia. Necesitamos saber qué representa el objeto que hemos pulsado y cómo se accede a su información. Una puerta puede estar compuesta visualmente por varias piezas, y una selección que funciona bien para ocultar geometría puede no ser suficiente para guardar una incidencia. En los datos revisaría por separado propiedades de instancia y de tipo, unidades y valores vacíos. Si el equipo busca un código, debe poder reconocer su conjunto de propiedades y su origen, en vez de elegir el primero de varios campos llamados «Código» por orden de aparición.
Para los filtros, prepararía una consulta con una respuesta conocida: determinadas puertas de una planta o elementos con una clasificación concreta. Después comprobaría qué devuelve y qué ocurre cuando el dato no existe. No hace falta convertir el visor en una herramienta de validación formal; sí entender la fiabilidad de las consultas que vamos a utilizar. Si una tabla suma áreas, habría que conocer qué entidades suma y con qué unidades. Que el total cambie al ocultar una disciplina puede ser correcto o revelar un malentendido. La interfaz necesita permitir averiguarlo.
En una federación, comprobaría además la posición relativa de los modelos y las transformaciones aplicadas. Cada archivo puede abrirse perfectamente por separado y quedar mal ubicado al combinarlo. Guardaría evidencia de un par de referencias conocidas, con la configuración utilizada. Un gran rendimiento no compensa coordinar dos disciplinas colocadas en universos paralelos. La geometría debe ser suficiente para el propósito y las referencias deben permitir entender el conjunto, sin atribuirle al visor correcciones que pertenecen a la preparación del proyecto.
Medir el recorrido completo en condiciones razonables
El tiempo hasta ver la primera imagen es un dato útil, pero la tarea continúa después. Interesa saber cuándo se puede navegar, cuánto tarda una búsqueda y si consultar propiedades interrumpe el trabajo. Un visor puede mostrar pronto una escena incompleta y otro esperar antes de ofrecer una interacción más estable. Para compararlos, registraría hitos del mismo recorrido en lugar de una única cifra de «carga». También distinguiría una primera apertura de una posterior, porque la caché o una conversión previa pueden cambiar la experiencia.
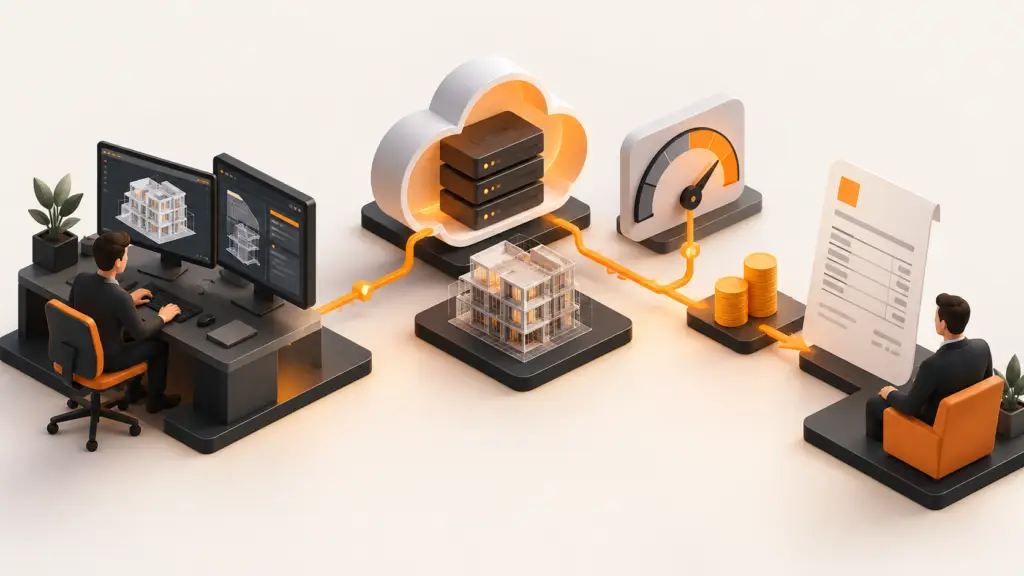
El procesamiento puede ocurrir en el dispositivo, en un servidor o en una combinación de ambos. Un ejemplo concreto es el flujo IfcLoader de That Open, que convierte IFC a Fragments y permite reutilizar esa representación. Este tipo de preparación ayuda a entender por qué la primera conversión y la consulta posterior no son necesariamente la misma operación. Al evaluar una solución, conviene preguntar qué se procesa, dónde se guarda y qué paso estamos midiendo, sin extender una ventaja de un caso concreto a todos los modelos.
Utilizaría los equipos y la conexión que se esperan en el trabajo habitual. La estación del desarrollador puede formar parte de la prueba, pero también un portátil corriente o el dispositivo previsto para obra. No hay un tamaño de archivo universal a partir del cual todos los visores se comporten igual: influyen geometría, cantidad de objetos, datos, implementación y recursos disponibles. Un límite de megabytes declarado en un plan comercial tampoco explica por sí solo si una sesión larga será cómoda.
Además de abrir, probaría cambiar de modelo varias veces, aplicar filtros y volver a una vista guardada. Si la memoria crece o la navegación se degrada, interesa saber cuándo ocurre y si existe una forma comprensible de recuperarse. Una solución puede ofrecer carga parcial o limitar determinadas operaciones; lo razonable es comprobar que esos límites se comuniquen y encajen con el uso. Esperar a que el navegador se cierre para descubrirlos es un sistema de diagnóstico bastante expresivo, aunque poco considerado con el usuario.
Las evidencias necesitan contexto: versión del producto, archivo utilizado, dispositivo, navegador y condiciones de la prueba. Repetir el mismo recorrido ayuda a separar un comportamiento habitual de una incidencia puntual. Si no se ha medido algo, se deja pendiente; si solo aparece en la documentación, se registra como declaración del proveedor. Conservar esta distinción permite discutir la elección con honestidad y repetirla cuando cambie la tecnología. Un resultado de prueba es una observación situada, no un juramento de rendimiento eterno.
Comprobar la colaboración y la salida de la información
Si el objetivo incluye gestionar observaciones, la evaluación tiene que recorrer una incidencia completa: crearla con contexto, asignarla cuando proceda, responder y revisar su resolución. Un punto sobre el modelo puede ser el inicio de ese recorrido. Hace falta saber qué conserva: versión, elementos, cámara, comentarios y estado. También qué ocurre cuando llega una nueva entrega. Si el elemento desaparece, la herramienta debería permitir reconocer esa situación y mantener el contexto histórico, en lugar de aparentar que toda referencia sigue siendo válida.
BCF puede servir para intercambiar información de incidencias entre aplicaciones. La especificación de BCF API de buildingSMART contempla temas, comentarios y puntos de vista con información como cámara y componentes. Eso ofrece una base para el intercambio, pero un botón BCF no demuestra que el recorrido entre nuestras herramientas funcione como necesitamos. Probaría exportar un caso concreto, abrirlo en la aplicación de destino y comprobar qué contexto conserva. Si necesitamos un recorrido de ida y vuelta, hay que comprobar también el regreso.
La gestión del acceso requiere pruebas con papeles distintos. La persona externa debería consultar solo lo previsto; quien coordina podría tener otras acciones. Conviene revisar también los enlaces compartidos y el resultado de retirar el acceso, siguiendo la política de la plataforma. El hecho de que una página deje de abrir no elimina necesariamente una descarga previa. Esta diferencia importa cuando se promete revocación: hay que entender qué controla el sistema y qué información ya ha salido hacia un dispositivo.
Antes de subir modelos, revisaría las condiciones de almacenamiento, ubicación, retención y borrado aplicables al servicio y al proyecto. Una aplicación que procesa archivos en el navegador puede tener dependencias o funciones que transmitan información; una plataforma alojada puede ofrecer controles adecuados para el caso. Ninguna etiqueta sustituye la comprobación del recorrido de los datos. Si algo no está claro, es una condición pendiente de resolver antes de usar archivos que no deban compartirse en ese entorno.
También preguntaría cómo salir. ¿Podemos recuperar incidencias, vistas, datos y relaciones de versión de forma utilizable? Si integramos el visor en un portal, ¿qué API o SDK permite seleccionar objetos y obtener la información necesaria? Un componente para desarrollar y una plataforma colaborativa terminada son adquisiciones distintas, con esfuerzos distintos. Elegir una base abierta puede dar control, pero alguien tendrá que mantener la aplicación alrededor. Elegir un servicio gestionado puede reducir ese trabajo y añadir dependencias que conviene conocer mientras todavía es fácil cambiar de idea.
Elegir con evidencias y confirmar la decisión en un piloto
Con las pruebas anteriores, prepararía una comparación breve por candidato: tarea, resultado observado, limitación y evidencia. Solo después añadiría una valoración según su importancia. El acceso a los datos y la coordinación entre disciplinas podrían ser imprescindibles; una personalización visual, secundaria. Si una función no se ha podido comprobar, no le concedería la misma certeza que a una tarea completada. Una puntuación sin estas notas puede producir un ganador muy convincente que nadie sabe defender cuando empieza a utilizarlo.
El coste debería incluir el escenario completo: usuarios, almacenamiento, procesamiento, integración y soporte, según las condiciones vigentes de cada producto. Para un componente propio habrá desarrollo y operación; para un servicio, límites y condiciones que revisar. La comparación mejora si incluye una previsión de uso habitual y otra de mayor actividad, con sus supuestos explícitos. Evita llamar «gratis» a lo que consume semanas del equipo o «caro» a un servicio sin considerar el trabajo que sustituye.
Antes de extender la elección a todos los proyectos, haría un piloto acotado con personas que deban completar tareas reales. Interesa observar si encuentran propiedades, entienden qué entrega está abierta y consiguen comunicar una observación con contexto. La navegación 3D tampoco debería ser el único acceso: búsqueda, listas y controles comprensibles pueden resultar decisivos para personas menos familiarizadas con el modelo. El soporte que pide ese grupo aporta información que una demostración guiada rara vez revela.
La elección puede ser una plataforma, una biblioteca o una solución sencilla para consultas ocasionales. Defiéndela con las pruebas del uso previsto y con los límites que aceptas mantener. Si el argumento principal sigue siendo que el ejemplo cargaba muy rápido, amplía la muestra antes del contrato. El cubo se ha portado bien; todavía no ha demostrado que conozca tu proyecto.
Respuestas